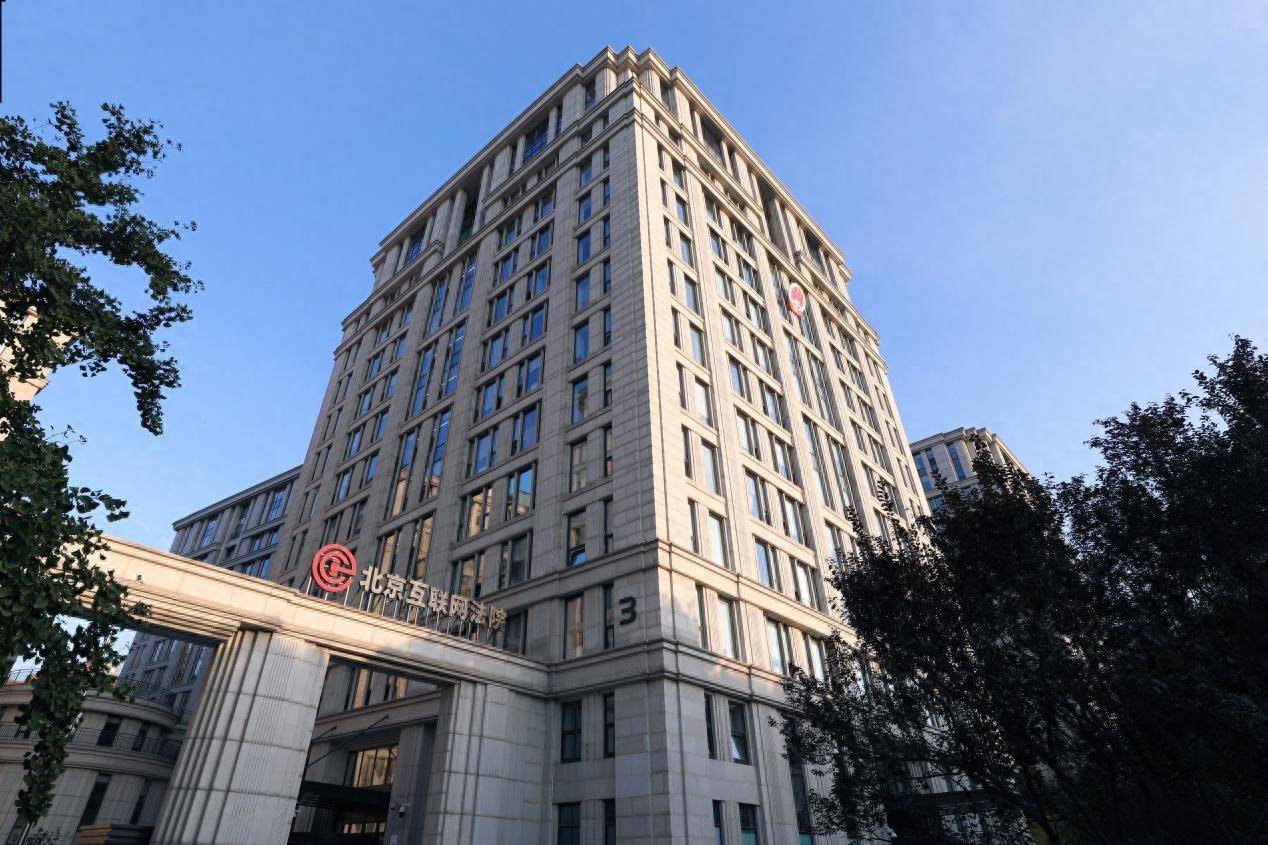
2026年9月,最高人民法院出台涉人工智能纠纷案件审理意见。这份文件中的多项规则,都能在北京互联网法院过去八年的判决中找到影子。
八年前,北京互联网法院挂牌时,“生成式人工智能”还是一个遥远的技术名词。如今,它已渗入普通人的日常:一句提示词生成一幅画,几张照片换一张脸,一段录音克隆一种声音。技术狂奔的同时,纠纷涌入法庭。该院党组成员、副院长赵长新介绍,截至今年7月,北京互联网法院累计受理案件超28万件,涉AI案件增速显著,涵盖著作权、人格权、网络服务合同等多个领域。
“AI只是工具,权利归属于人,责任要落到人身上。”赵长新的这句话,道出了这家法院审理涉AI案件一以贯之的底层逻辑。
一幅“少女图”,叩开AI作品确权之门
2023年2月,网民李先生想画一幅“黄昏光线下的亚洲少女”图。他没有拿画笔,而是打开了Stable Diffusion——当时最主流的AI绘画大模型之一。
据李先生描述,他花了几个月在论坛里学习,摸索正向提示词、负向提示词的写法,调整参数,设置“随机数种子”,反复调试了多轮,最终生成了一张图,命名为《春风送来了温柔》,发在自己的社交账号上。
十天后,刘女士在另一个平台发布原创诗歌时,把这张图拿来做了配图,还截掉了平台添加的署名水印。
案子到了北京互联网法院。一个没有先例的问题摆在合议庭面前:用AI“画”出来的图,算不算作品,权利又该归于何方?
全国首例“AI文生图”著作权案庭审现场
该案作为新类型前沿典型案件,由该院综合审判一庭庭长朱阁担任审判长组成合议庭审理。为读懂生成式AI背后的技术机理,朱阁没有停留在纸面卷宗,而是深入产业一线和技术工程师面对面交流,厘清提示词、参数如何一步步塑造最终画面。
“生成式AI不是搜索引擎,给你一张现成的图让你挑;也不是以前那种判别式AI,给你一个模板往里填数据。”朱阁用通俗的语言解释:这个工具把“画笔”交给了用户,用户通过提示词的选择、参数的调整、多轮的筛选,对最终的线条、色彩、画面布局做出了“安排和选择”。
2023年11月27日,判决出炉:涉案图片构成美术作品,原告是作者,享有著作权。被告赔偿500元。
判赔金额不大,但那份判决搭建起了AI生成内容确权的重要司法范式。
这种“不因形式之新而轻易否定,也不因技术之热而降低门槛”的裁判逻辑,早在建院之初就已埋下伏笔。
2018年,北京互联网法院成立后的首案,有关于一段仅13秒的短视频是否算著作权法保护的“作品”。当时合议庭内部也有分歧:有人认为太短了,跟传统影视作品没法比。法官会议上一遍遍播放,画面从灰暗渐变为光亮,传递出对汶川地震逝者的缅怀,触动了在场的所有人。
合议庭最终达成共识:短视频是否构成作品,和时长无关,核心要看是否蕴含独创性智力劳动与个性化表达。“著作权法始终关注的,是对于人的创造力的保护。”朱阁说。
AI不是挡箭牌,侵权责任归于使用者
AI是一把双刃剑。享受工具赋能的同时,AI恶搞、AI换脸、AI克隆声音等纠纷接踵而至。如果说“AI文生图案”的判决回答的是“权利归谁”,那么另一批案件判决回答的则是“责任归谁”。
全国首例AI生成声音人格权侵权案庭审现场
配音演员殷某某就遭遇过声音被AI“盗用”的困境。她曾接受一家文化传媒公司委托录制录音制品,该公司是录音制品的著作权人。后来,这家公司把录音数据提供给了某软件公司。软件公司仅用这一部录音制品作为素材,做了AI化处理,生成了一个文本转语音产品,挂在云服务平台上对外出售。再经过几道转手,这款AI声音产品最终出现在某智能科技公司的配音软件中,相关配音作品的播放量高达32亿余次。
庭审现场,法官当庭勘验:AI产品生成的语音,与殷某某本人的音色、语调、发音风格高度一致。
五个被告均否认侵权,被告某文化传媒公司辩称:文化传媒公司获得了授权,对录音制品享有著作权。
最终判令侵权主体赔礼道歉,综合产品播放量、同类市场价值,酌定赔偿经济损失25万元,一审判决生效。
涉案肖像照及群聊发布的AI生成图片
普通人之间,同样会因为不当使用AI导致人格权侵权。在一起微信群纠纷中,被告拿群内原告微信头像照片,利用AI生成衣着暴露、形体畸形的动漫图片,不仅点对点私信发送给当事人,还发到交流微信群。“图片是AI自动生成,和我无关。”庭审中,被告试图把过错推给AI技术。
“即便图像由算法运算得出,但使用工具、实施传播行为的是人,侵权责任理应由使用者承担。”该院党组成员、副院长孙铭溪一语道破。
孙铭溪审理的全国首例AI陪伴案也备受关注。某记账软件里,用户可以自行创设“AI陪伴角色”,设置名称、头像和人物关系。一位公众人物“何某”被大量用户设置为陪伴人物,软件还通过算法推荐、提供“调教”机制,让用户上传语料、营造真实互动体验。平台认为,自己只是中立存储服务商,全部内容由用户上传。
法院认定,这构成了对姓名权、肖像权和一般人格权的侵害。关键理由在于:被告不是被动的技术服务提供者,它通过规则和算法设计,实质性地组织、鼓励了侵权内容的生成,应当作为内容服务提供者承担责任。
算法不能“一言定罪”,平台处罚须释明理由
人工智能产业链环环相扣,模型研发方、平台服务商、普通用户深度交织在一起。司法既要守牢人格权、著作权的民生底线,也不愿为技术创新套上过重枷锁。分寸的拿捏,考验着审判者的智慧。
2024年,一位用户在社交平台上发了一段两百多字的随笔,大意是“打工赚不到多少钱,但能开启新视角,如果打算开车,可以在最清闲的假期把驾照学了”。平台算法判定这属于“包含AI生成内容但未标识”,直接隐藏了帖子,还把账号禁言了一天。
用户申诉,平台回复:人工复核后,认为“没有发现明显的人类特征”。
用户一纸诉状把平台告上了法庭。
但法庭看到现实困境:这只是一条即时性网络随笔,普通人在社交平台有感而发,大多不会提前在文档软件写底稿,客观上拿不出草稿、源文件来自证“是人写的”。如果将全部举证责任压给普通用户,普通人几乎没有自证清白的途径。
法院充分肯定,平台利用算法筛查AI生成内容,落实AI合成内容标识义务,属于履行平台内容治理责任。但平台既是算法掌控者,又是处罚的裁判者,手握技术优势,不能躲进算法“黑箱”,仅仅抛出处罚结论,却拒绝解释判断逻辑。
法院最终判平台败诉,要求恢复内容展示、删除违规记录。这起判例给所有互联网平台敲响警钟:算法审核可以使用,但不能信奉“算法即正义”。
时至今日,随着人工智能生成合成内容相关管理规定落地,AI内容标识已经成为法定义务,平台需要甄别AI生成内容,但同时必须建立容错、解释、有效的申诉机制,治理AI乱象,不能以误伤普通用户原创表达为代价。
把层出不穷的网络新纠纷纳入已有的法律轨道
在北京互联网法院,一份判决书的落地,往往不是治理的终点。
“互联网自带创新的基因,新业态、新模式不断冒出来,新的纠纷就会不断出现。”朱阁认为,法官的使命,就是立足现行法律,把层出不穷的网络新纠纷纳入已有的法律轨道,为数字社会确立稳定预期。
“我们始终坚持‘审理一案、治理一片’的思路,把个案当中沉淀的裁判理念,向外转化为行业指引乃至制度参考,推动人工智能朝着向善有序的方向演进。” 该院党组书记、院长姜颖指出,互联网法院的工作重心,已经从最初的机制探索、平台建设,向确立规则、完善制度等方面拓展提升,其核心功能更加聚焦完善互联网审判体系,公正高效审理各类新型互联网案件,助推网络空间依法治理。
北京互联网法院在北京数据基础制度先行区设立数据权益法官工作站
北京日报客户端


 京公网安备 11011402013531号